
Ситуация в компаниях повторяется почти дословно: бизнесу нужна быстрая автоматизация, ИТ-подразделение смотрит на low-code, а сверху добавляется требование «чтобы был искусственный интеллект». Дальше начинается перебор вендорских презентаций, в которых у всех есть и агенты, и LLM, и RAG. На портале cio-navigator.ru вышел подробный обзор российских low-code платформ с ИИ-функциями, который как раз разбирает, чем отличаются эти «одинаковые» предложения друг от друга.
Какие ошибки чаще всего встречаются при выборе?
Большинство просчётов случается ещё до пилота — на этапе, когда формируется короткий список решений. Ошибки при этом довольно типовые.
- Считать наличие ИИ-ассистента признаком зрелости платформы. Чат-окно в интерфейсе и агент, встроенный в бизнес-процесс, — разные уровни интеграции.
- Игнорировать архитектуру. Микросервисы, модульный монолит, наличие RPA-компонентов напрямую влияют на масштабирование и эксплуатацию.
- Не спрашивать про контекст агентов. Общий контекст на нескольких агентов и отдельный контекст для каждого дают разную предсказуемость работы.
- Забывать про токены. Если расход нельзя посчитать по каждому агенту отдельно, стоимость владения решением становится плохо прогнозируемой.
- Путать вайб-кодинг с промышленной разработкой. Быстрый прототип по промпту и корпоративная система с правами доступа, интеграциями и требованиями регуляторов — задачи разного класса.
- Оценивать платформу по количеству заявленных функций, а не по их применимости к конкретным процессам.
Почему такие промахи происходят?
Причина простая: рынок изменился быстрее, чем сформировался язык для его описания. Low-code изначально был про визуальную сборку приложений — готовые компоненты, настройка логики, интеграции без ручного кода. Теперь к этому добавился слой генеративных моделей, и одни и те же слова начали означать разные вещи у разных вендоров.
В обзоре хорошо видно, насколько по-разному производители трактуют «ИИ в платформе». У кого-то модели участвуют в жизненном цикле разработки — от спецификации до автотестов. У кого-то ИИ живёт внутри прикладных сценариев: скоринг, классификация обращений, обработка документов. У третьих агенты настраиваются в визуальном редакторе и работают как обычный шаг процесса. Все формулировки честные, но сравнивать их «в лоб» бессмысленно.
Добавляет путаницы и вопрос безопасности. Для корпоративного контура критично, можно ли развернуть модель локально и не уйдут ли данные во внешние сервисы. Эксперты, которых цитирует исследование, отмечают устойчивый спрос на изолированные контуры и поддержку локальных языковых моделей.
Чем помогает сравнение платформ из исследования?
Рейтинг подготовил Санкт-Петербургский Клуб ИТ-директоров. Решения оценивались по 174 критериям, охватывающим ИИ-возможности, архитектуру, инструменты разработки и другие характеристики, значимые для enterprise-сегмента. Для функциональных параметров применялась трёхбалльная шкала: полная реализация, частичная и отсутствие функции. Показатели, которые нельзя свести к «есть/нет», переводились в восьмибалльную шкалу по диапазонам.
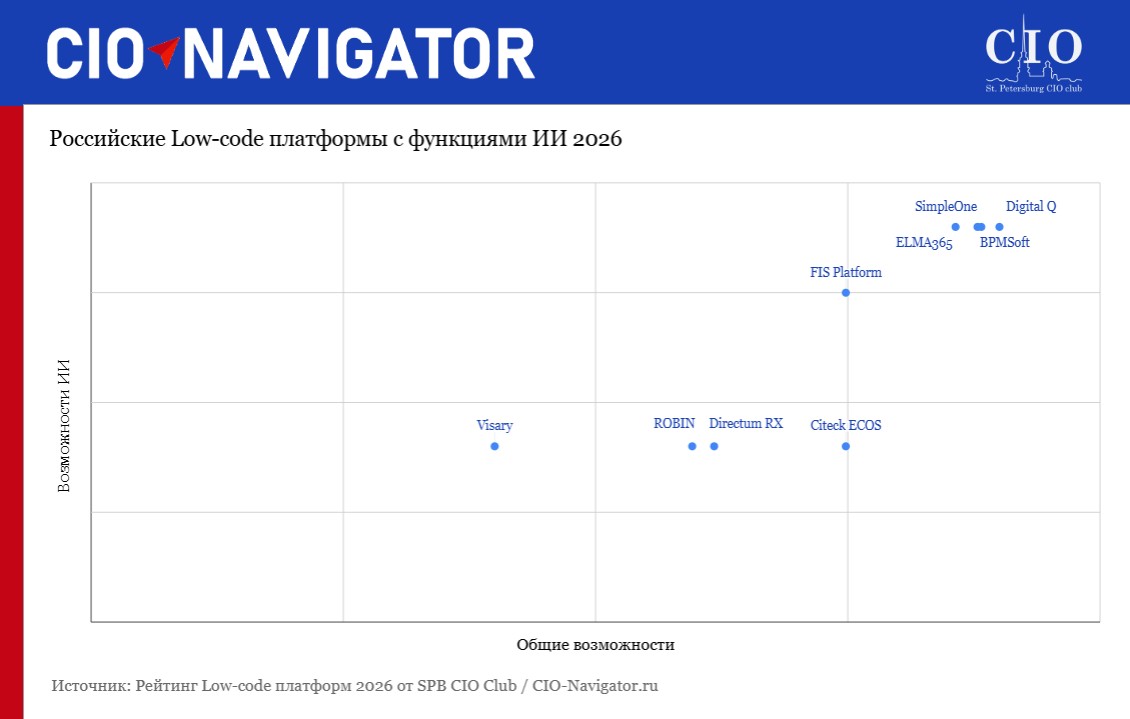
Отдельные разделы посвящены именно тем деталям, которые обычно выпадают из переговоров с вендором: типам архитектуры, организации контекста AI-агентов и возможности подсчёта токенов на уровне каждого агента. Плюс краткие профили девяти решений — Digital Q, BPMSoft, SimpleOne, ELMA365, FIS Platform, Directum RX, Citeck ECOS, ROBIN, «БФТ.Платформа» и Visary. Все они входят в Единый реестр российского ПО. Полная рейтинговая таблица вынесена в приложение: https://cio-navigator.ru/sravnenie-ai-low-code-2026/
Есть в публикации и практическая часть — таблицы с целевой аудиторией каждой платформы. Они помогают сразу отсечь неподходящие варианты: часть решений ориентирована на банки и финтех, часть — на холдинги и госсектор, часть — на компании с большим объёмом документооборота.
Что за портал публикует такие сравнения?
Ресурс cio-navigator.ru специализируется на обзорах корпоративного ПО и темах, близких ИТ-директорам: автоматизация бизнес-процессов, BPM, RPA, стоимость владения, нотации моделирования. Рейтинги здесь строятся на анкетировании вендоров и формализованных критериях, а не на редакционных впечатлениях, поэтому их удобно использовать как основу для собственного сравнительного анализа.
Что в итоге?
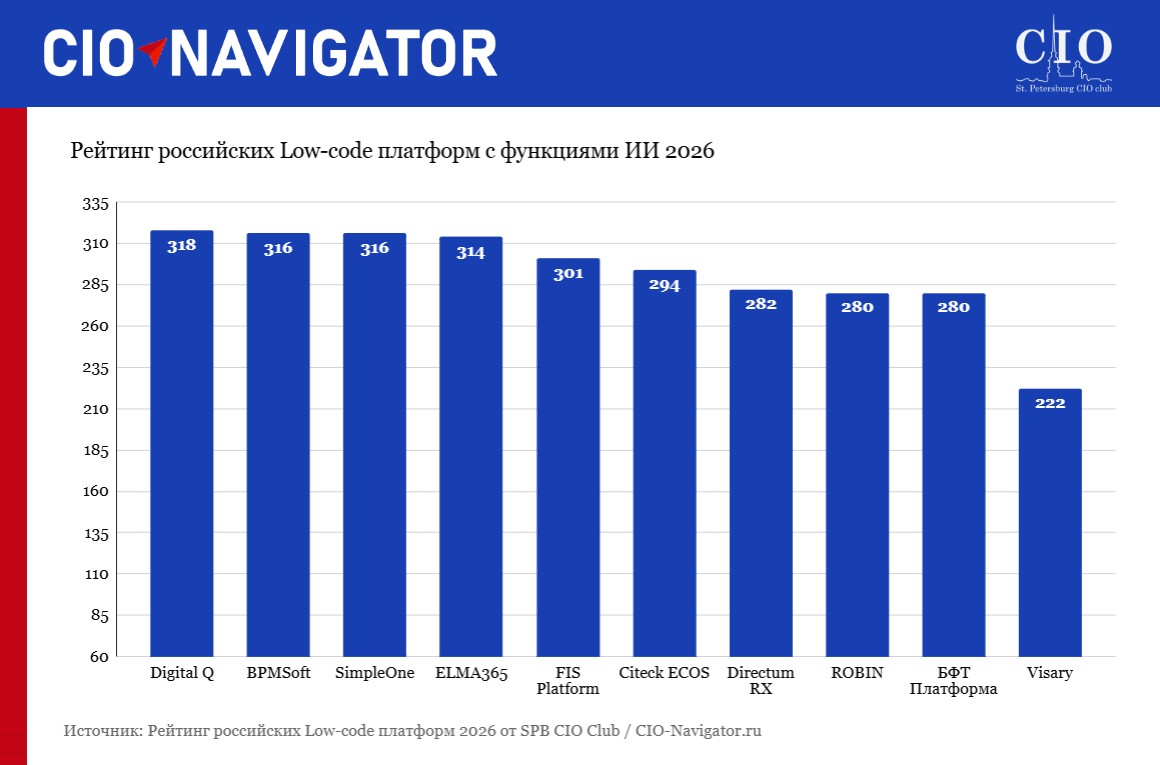
Главный вывод исследования звучит не слишком эффектно, зато полезно: значение имеет не число ИИ-функций, а глубина их встраивания в платформу и применимость к реальным задачам. ИИ постепенно перестаёт быть надстройкой и становится обязательным компонентом low-code-среды — от помощи в разработке до агентов, выполняющих поручения внутри процессов.
Использовать такой рейтинг как готовый ответ не получится и не нужно. Разумнее взять его как карту рынка: сузить список кандидатов, сформулировать вопросы к вендорам про контекст, токены и работу в закрытом контуре, а окончательное решение принимать по результатам пилота на собственных процессах.